서버 대수가 늘어나고 컨테이너 기반 마이크로서비스로 전환되면, 단순히 CPU나 메모리 사용량에 임계치 알람을 거는 것만으로는 장애 원인을 찾기 어렵습니다.
수많은 서비스가 얽힌 분산 환경에서 요청 지연과 오류를 추적하기 위한 OpenTelemetry 수집 파이프라인 구성과 MELT 신호 연계, 그리고 AIOps를 활용한 경보 노이즈 필터링 방식을 정리합니다.
1. 모니터링과 관측성
기존 대시보드 모니터링 환경에서는 'CPU 점유율 90% 초과' 같은 알람이 발생해도, 정작 어떤 서비스의 어떤 요청 때문에 병목이 생겼는지는 바로 알 수 없습니다. 서버가 멎었다는 사실(What)은 대시보드에 빨간불로 뜨지만, 왜 멎었는지(Why)는 개별 서버에 SSH로 들어가 로그를 일일이 뒤져봐야 알 수 있습니다.
단일 모놀리스 환경에서는 이런 방식도 통했지만, 서비스 수십 개가 REST나 gRPC로 얽힌 환경에서는 통하지 않습니다. 이때 필요한 것이 관측성(Observability)입니다. 시스템 외부로 노출되는 텔레메트리(지표, 이벤트, 로그, 트레이스)를 바탕으로 내부 실행 흐름과 의존 관계를 역추적하는 접근법입니다.
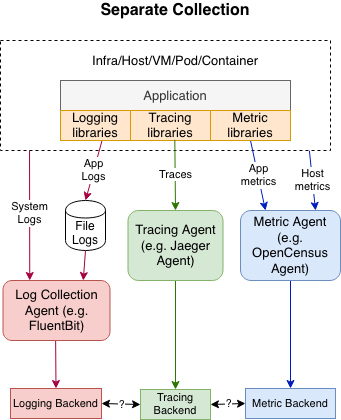
위 그림처럼 기존 인프라는 메트릭 수집기, 로그 수집기, APM 도구가 제각각 흩어져 있어 장애가 났을 때 타임스탬프를 손으로 맞춰가며 인과관계를 찾아야 했습니다. AIOps(인공지능 기반 IT 운영)는 이렇게 분리되어 들어오던 다차원 데이터를 하나의 분석 파이프라인으로 묶어 서비스 간 종속 관계를 파악합니다.
2. MELT 텔레메트리

관측성을 확보하려면 시스템에서 네 가지 기본 신호(Metrics, Events, Logs, Traces)를 유기적으로 수집해야 합니다. 앞 글자를 따서 흔히 MELT라고 부릅니다.
메트릭(Metrics)은 CPU, 메모리 사용량, 네트워크 I/O, 초당 요청 수(RPS) 같은 수치 데이터입니다. 시계열 데이터베이스에 가볍게 저장할 수 있어 시스템 전반의 이상 징후를 가장 먼저 감지하는 용도로 쓰입니다.
이벤트(Events)는 컨테이너 재시작, 파드(Pod) 오토스케일링, 새 버전 배포처럼 특정 시점에 일어난 상태 변화 기록입니다. 지표가 튀는 시점과 배포 이벤트의 타임스탬프가 겹친다면 문제 원인을 특정하기가 훨씬 수월해집니다.
로그(Logs)는 애플리케이션이 남기는 문자열 기록입니다. 에러가 발생한 지점의 스택 트레이스나 상세 파라미터를 확인할 때 가장 확실한 단서가 되지만, 데이터양이 방대해 검색 비용과 저장 공간 관리가 까다롭습니다.
트레이스(Traces)는 클라이언트의 단일 요청이 프론트엔드, API 게이트웨이, 마이크로서비스, 데이터베이스를 거쳐 나가는 전체 호출 경로를 기록합니다. 분산 환경에서 지연이 어느 구간에서 발생했는지 파악할 때 없어서는 안 될 핵심 신호입니다.
3. OpenTelemetry 구조
도구마다 제각각이던 에이전트와 프로토콜 파편화를 해결하기 위해 나온 오픈소스 표준이 CNCF의 OpenTelemetry(OTel)입니다. SDK로 애플리케이션 코드를 계측하고, OTel Collector를 통해 데이터를 중앙으로 취합합니다.

OTel Collector의 파이프라인은 크게 수신(Receivers), 처리(Processors), 전송(Exporters) 세 단계로 구성됩니다. 애플리케이션에서 보낸 OTLP(OpenTelemetry Protocol) 데이터를 받아서, 메모리 사용량을 제어하거나 민감 정보를 마스킹한 뒤 목적지 스토리지로 보냅니다.

실제 쿠버네티스 클러스터 환경에서는 보통 2계층 구조를 많이 씁니다. 각 워커 노드마다 데몬셋(DaemonSet) 형태로 경량 에이전트를 띄워 로컬 컨테이너의 텔레메트리를 수집하고, 중앙의 게이트웨이 Collector로 모아서 외부 관측성 백엔드로 전송하는 방식입니다. 노드 내부 통신 부하를 줄이면서도 중앙에서 버퍼링과 전송 정책을 통제할 수 있습니다.
# OpenTelemetry Collector 파이프라인 구성 예시 (otel-collector-config.yaml)
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  batch:
    timeout: 1s
    send_batch_size: 1024
  memory_limiter:
    check_interval: 1s
    limit_percentage: 75
    spike_limit_percentage: 20

exporters:
  prometheus:
    endpoint: 0.0.0.0:8889
  otlp/aiops:
    endpoint: aiops-engine.internal:4317
    tls:
      insecure: false

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp/aiops]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus, otlp/aiops]
설정 파일 예시를 보면 파이프라인 구조가 명확히 드러납니다. 트래픽 급증 시 Collector 프로세스가 메모리 부족(OOM)으로 종료되지 않도록 memory_limiter와 batch 프로세서를 구성해 두는 것이 권장됩니다.
4. 분산 추적과 RCA
서비스 간 비동기 메시지 큐와 원격 호출이 얽혀 있으면, 특정 API의 응답 속도가 3초로 늘어났을 때 어느 서비스가 지연을 유발했는지 찾아내기가 매우 어렵습니다.
분산 추적(Distributed Tracing)은 요청 헤더에 고유한 Trace ID와 Span ID를 실어 보내 호출 흐름 전체를 연결합니다.

그림처럼 하나의 요청이 여러 서비스를 거칠 때 각 구간별 소요 시간(Span)이 타임라인 워터폴 형태로 시각화됩니다. 데이터베이스 쿼리 수행 시간이 길었는지, 외부 결제사 API 응답이 늦었는지 한눈에 드러납니다.
AIOps 시스템은 이 워터폴 데이터에서 가장 지연에 영향을 많이 준 임계 경로(Critical Path)를 자동으로 찾아냅니다. 게다가 에러 로그에도 같은 Trace ID가 찍혀 나오기 때문에, 지연이 발생한 바로 그 스팬의 로그와 예외 스택을 다른 서버 로그를 헤맬 필요 없이 바로 열어볼 수 있습니다. 평균 복구 시간(MTTR)을 단축하는 원리입니다.
5. 이상 탐지와 경보 상관분석
네트워크 스위치 하나나 공유 데이터베이스 하나에 장애가 생기면, 그 위에 물려 있는 수십 개 서비스에서 동시에 경보가 터집니다. 이른바 경보 폭풍(Alert Storm) 현상입니다. 온콜 담당자에게 수백 통의 슬랙 알림과 문자가 쏟아지면 정작 어디가 최초 진원지인지 찾지 못하고 화면만 보게 됩니다.
경보 상관분석(Alert Correlation)은 서비스 간 의존 관계(토폴로지)를 기반으로 동시에 쏟아지는 경보들을 하나의 인시던트(Incident)로 묶어줍니다. 하위 서비스의 500 에러 알람 수십 개를 띄우는 대신, '인증 DB 연결 실패로 인한 12개 서비스 연쇄 호출 지연' 형태로 근본 원인(Root Cause)을 묶어서 알려주는 방식입니다.
또한 평일 낮과 심야 시간대의 정상 트래픽 패턴이 다른 만큼, 고정된 임계치 대신 머신러닝 기반 동적 베이스라인을 적용하면 불필요한 야간 오탐 경보를 크게 줄일 수 있습니다.
6. 구축 체크리스트
| 구분 | 핵심 과제 | 권장 기술 / 적용 기준 |
|---|---|---|
| 표준화 | OTel SDK 적용 | W3C TraceContext 헤더 검증 |
| 수집 계층 | 2계층 Collector 배포 | DaemonSet 메모리 리미터 최적화 |
| 보안 | PII 마스킹 | 정규식 필터링, 전송 구간 TLS |
| ML 분석 | 동적 임계치 감지 | 14일 시계열 데이터 학습 |
| 경보 그룹 | 토폴로지 상관분석 | 인시던트 단일화 및 중복 차단 |
| 신호 | 데이터 형태 | 대표 도구 | AIOps 활용 |
|---|---|---|---|
| Metrics | 시계열 수치 (CPU, 지연) | Prometheus | 동적 임계치, 이상 탐지 |
| Events | 상태 변화 (배포, 재시작) | K8s Events | 장애 시점 인과 추론 |
| Logs | 텍스트 맥락 (에러 로그) | Fluent Bit | 템플릿 마이닝, 패턴 분석 |
| Traces | 분산 경로 (스팬, 워터폴) | Jaeger, Tempo | 병목 지점, 임계 경로 추적 |
실제 도입 시 처음부터 모든 마이크로서비스에 트레이싱과 AI 분석을 전부 적용하려고 하면 수집 비용과 운영 복잡도가 급격히 올라갑니다. 주요 진입점(API Gateway)과 병목이 잦은 데이터베이스 계층부터 OTel SDK 계측을 시작하고, 점진적으로 수집 범위를 넓혀가는 것이 현실적인 접근입니다.
'AI > Agent' 카테고리의 다른 글
| Harness 기반 AIOps Agent 구축 2 (0) | 2026.09.30 |
|---|---|
| Harness 기반 AIOps Agent 구축 1 (0) | 2026.09.30 |
| Google Antigravity 2달러에 구매하기 (Gemini 3.7 flash, Claude Opus4.6) (0) | 2026.08.19 |
| Hermes agent 한달 사용기 (Orca, Omniroute, Claw3D) (0) | 2026.08.13 |
| Fable5 | AI 자동화 루프(loop) 설계 (0) | 2026.07.17 |